
谷歌披露第八代TPU技术细节:推理芯片用上288GB HBM,训练芯片能效达前代2倍
芯东西(公众号:aichip001)
编译 | 崔嫄伟
编辑 | 陈骏达
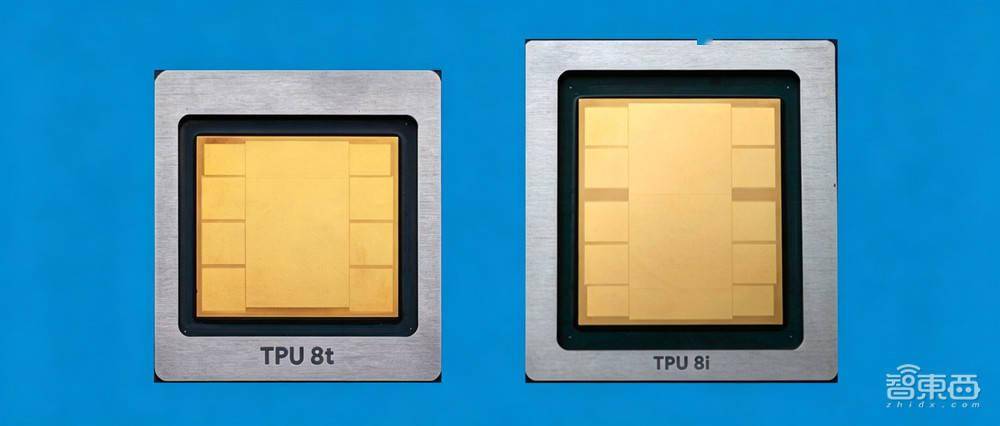
芯东西9月2日消息,8月26日,在全球顶级半导体架构研讨会Hot Chips 2026上,谷歌披露了第八代TPU(张量处理单元)的技术细节。这代TPU共有两款,分别是面向推理场景的TPU 8i与面向训练场景的TPU 8t。
这两款芯片此前已于今年的Google Cloud Next大会上首次亮相,这也是谷歌首次在一代产品中同时推出两款芯片。
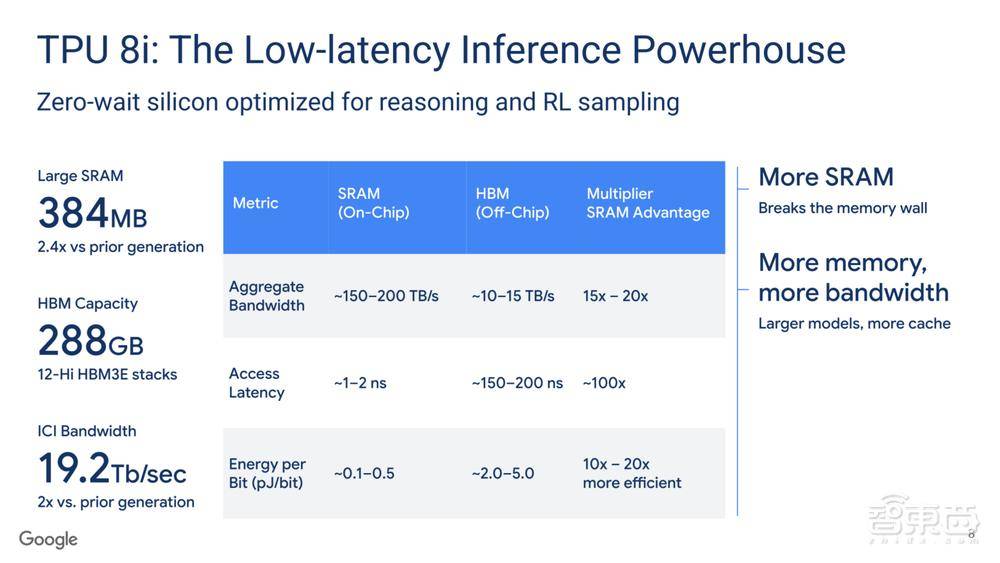
面向推理场景的TPU 8i定位为“低延迟推理引擎”。单颗芯片片上SRAM容量达384MB,是前代产品的2.4倍,更大的片上缓存可支撑更大规模模型运行,大幅减少片外内存访问;HBM总容量288GB,采用12层堆叠的HBM3E显存;片间互联(ICI)带宽达19.2Tb/s,较前代提升一倍。
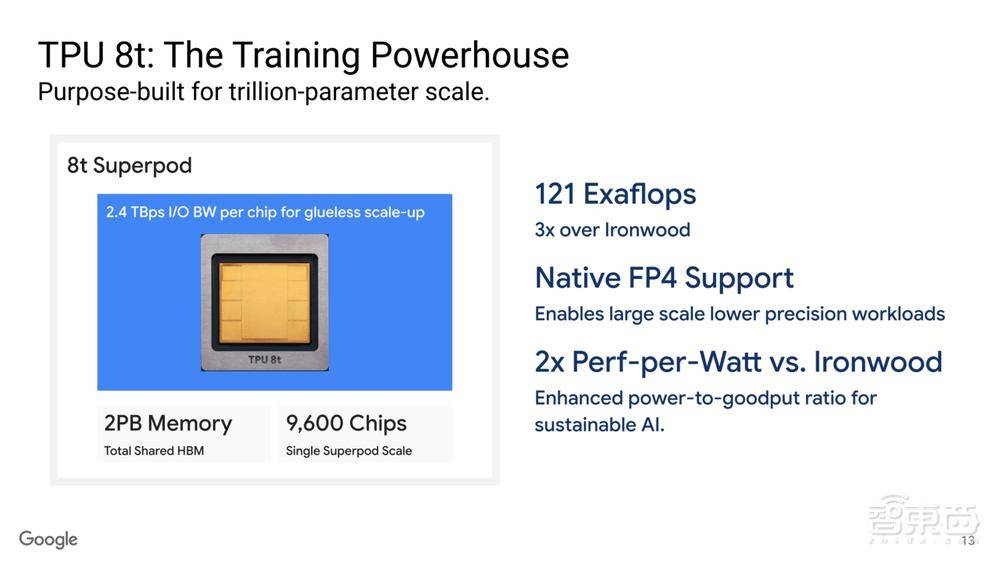
面向训练场景的TPU 8t则以浮点算力与高扩展互联为设计核心。本次大会,谷歌暂未披露TPU 8t芯片参数。从集群规格来看,单个TPU 8t Superpod集成9600颗芯片,通过光交换技术聚合为总容量2PB的全局共享HBM内存池;FP4精度下集群峰值总算力达121 EFLOPS,能效比达到第七代Ironwood TPU的2倍左右。
谷歌同时强调,并非所有计算环节都适合FP4低精度,该芯片对混合精度训练做了优化,可高效处理反向传播等对精度敏感的算子,在低功耗与训练稳定性之间取得平衡。
一、推理芯片TPU 8i:加大片上缓存与显存,单Pod最高1152颗芯片
从推理成本规律来看,延迟要求越低,算力成本就呈指数级上升;单用户请求速率越高,系统整体吞吐量就越低。为了在低延迟前提下提升推理效率,谷歌为TPU 8i大幅加码了片上缓存与显存配置。
SRAM与片外HBM的性能差距十分显著:片上SRAM的带宽是HBM的15-20倍,访问延迟仅为HBM的百分之一,每比特能耗仅为HBM的十分之一到二十分之一。通过大幅提升SRAM占比,TPU 8i有效缓解了推理场景的“内存墙”瓶颈。
互联架构上,TPU 8i支持多种拓扑,其中主打低延迟的是Boardfly拓扑:每个计算托盘搭载4颗TPU,每8个计算托盘构成一个全连接基本组,单Pod共包含36个基本组,最大可部署1152颗芯片。

谷歌前代产品多采用3D环面(3D Torus)拓扑,这种结构适合训练场景的高并行计算,但端到端延迟偏高。而Fly类网络天然具备低延迟特性,更适配推理负载:TPU 8i的Boardfly网络最大传输跳数仅为7跳,远低于3D环面的16跳,可更好支撑MoE推理所需的任意芯片间全交换通信需求。
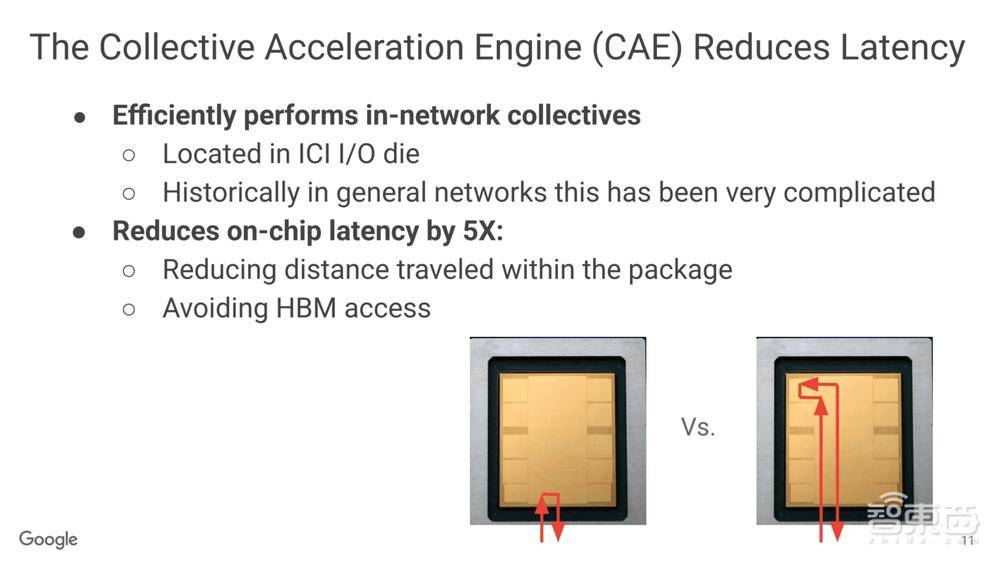
为进一步压缩集合运算延迟,谷歌为TPU 8i内置了集合加速引擎(CAE)。这类运算没有放在计算核心中处理,而是被放到芯片边缘、靠近网络硬件的ICI I/O裸片上。这种设计省去了数据向计算核心搬运的物理传输时间,也避免了额外的HBM读写开销,最终将片内集合运算延迟降低了80%。
二、训练端TPU 8t:Virgo网络搭配OCS光交换,单域可支持13.4万颗TPU
TPU 8t首次引入了训练专用的Virgo集群网络架构,替代前代复用的数据中心通用网络。单域内理论最多可支持13.4万颗TPU芯片,集群总带宽达47 Pb/s,对应全阵列FP4峰值算力可达1.6YFLOPS,面向多Superpod组网的超大规模训练场景。
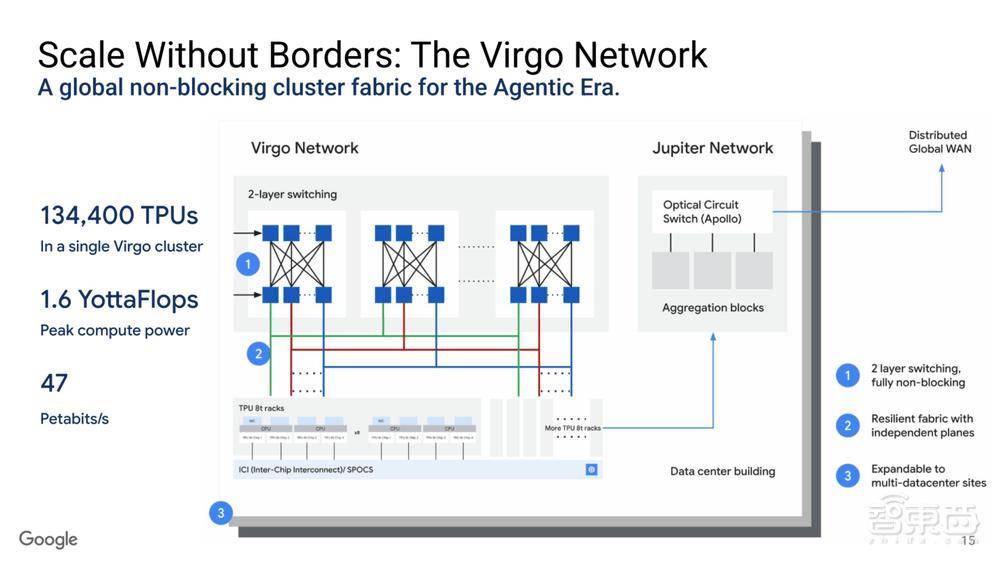
谷歌还通过自研光电路交换机(OCS),实现了9600颗芯片的内存池化与灵活调度。OCS架构具备高冗余与高可靠性,可在大Pod内动态划分任意规模、任意形态的算力切片,仅受总资源池容量限制。此外,OCS可自动处理芯片故障:检测到芯片失效时,自动将其剔除调度,分配备用节点并从检查点恢复训练,保障业务连续性。
可靠性、可用性与可维护性(RAS)始终是谷歌芯片设计的核心优先级。第八代TPU新增了在役单元测试功能,可在芯片空闲周期自动运行检测,提前发现局部故障;同时强化了HBM链路CRC校验、互联奇偶校验、多维度传感器监测与舰队级健康监控等机制。
散热方面,谷歌为TPU 8t配备了增强型水冷方案。这也是谷歌首次为光模块配备液冷散热,此前光模块均采用风冷设计。
三、AI参与芯片迭代:硬件面积功耗优化,软件侧实现代码无缝迁移
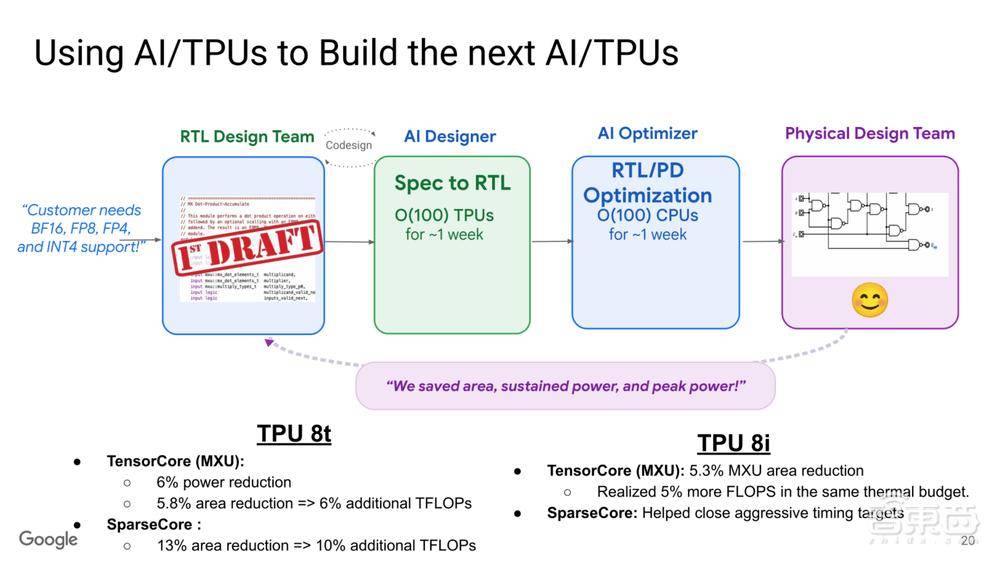
谷歌还将AI技术深度融入芯片设计流程,用现有TPU辅助迭代下一代TPU。AI优化模型成功缩减了TPU 8t的功耗,同时在两款芯片的多个模块上节省了芯片面积,让谷歌得以在相同功耗与面积预算下塞入更多计算单元。
这一举措具体优化成果包括:张量核心(MXU)方面,TPU 8t面积减少5.3%,功耗降低0.6%;TPU 8i面积减少5.8%,对应算力提升约6%;稀疏核心方面,面积减少13%,算力提升约10%;整体来看,在相同散热功耗约束下,额外释放了约5%的浮点算力。
软件层面,TPUv8系列对现有主流AI框架完全兼容,用户已有的JAX、PyTorch、Keras代码可无缝迁移,原生支持PyTorch Eager Mode等特性,迁移成本极低。
如果追求极致性能,开发者可使用谷歌自研的Pallas内核语言,直接用Python编写硬件感知的高性能内核,针对TPU 8i的CAE引擎与TPU 8t的稀疏核心做深度定制优化。XLA编译器会自动处理Boardfly拓扑调度、CAE同步等底层硬件细节,开发者只需聚焦模型逻辑本身,无需感知底层架构。
结语:训推分设拓宽专用芯片效率边界
长期以来,大模型训练多依赖通用架构芯片,单芯片兼顾训练与推理两种负载,会造成部分硬件资源闲置,芯片面积与功耗预算无法充分转化为实际算力。
训练、推理芯片分设的专用化路径,可针对两类负载的核心瓶颈定向优化,充分释放硬件性能潜力。随着这一技术路线的发展,AI芯片的训练与推理效率边界有望进一步拓宽,或将推动专用算力硬件迎来新一轮迭代升级。
来源:ServeTheHome(STH)